Generative AI Là Gì? Những mặt trái và thách thức đạo đức khi AI làm giả hiện thực
Trong vài năm gần đây, thế giới công nghệ đã chứng kiến những bước nhảy vọt kinh ngạc của trí tuệ nhân tạo (AI). Từ những bức tranh vẽ nguệch ngoạc ban đầu, giờ đây AI có thể tái tạo ra những bức ảnh chân dung, phong cảnh sắc nét đến từng chi tiết và những đoạn video chuyển động mượt mà không thể phân biệt nổi thật giả. Sự bùng nổ của các công cụ như Midjourney, Stable Diffusion hay Sora đã xóa nhòa ranh giới giữa thực tế và ảo ảnh. Vậy điều kỳ diệu nào ẩn giấu đằng sau thuật toán giúp máy tính có khả năng “vẽ” và “quay phim” giống hệt con người? Cùng Đại Pi Media tìm hiểu nhé!
AI Tạo Sinh (Generative AI) Là Gì?
AI tạo sinh (Generative AI) là một nhánh chuyên biệt của học máy (Machine Learning), tập trung vào việc huấn luyện các thuật toán để chúng có khả năng tự động tạo ra nội dung mới — bao gồm văn bản, hình ảnh, âm thanh và video — dựa trên dữ liệu mà chúng đã được học. Khác với các hệ thống AI truyền thống chỉ có nhiệm vụ phân loại hoặc dự đoán dữ liệu có sẵn, AI tạo sinh sở hữu năng lực “sáng tạo” mô phỏng theo tư duy nghệ thuật và logic của con người.
Khi nhận được một câu lệnh văn bản (prompt) từ người dùng, hệ thống không hề “lục tìm” một bức ảnh có sẵn trên internet để cắt dán, mà nó tự tính toán, sắp xếp các điểm ảnh (pixels) từ con số không để xây dựng nên một tác phẩm hoàn toàn mới, độc bản và mang độ chân thực đến kinh ngạc.
Cơ chế hoạt động của mô hình khuếch tán (Diffusion Models)
Hầu hết các công cụ tạo ảnh AI hiện đại ngày nay đều vận hành dựa trên một đột phá toán học gọi là Mô hình khuếch tán (Diffusion Models). Quá trình này được mô phỏng phỏng theo nguyên lý vật lý của sự khuếch tán phân tử:
- Giai đoạn thêm nhiễu (Forward Process): Trong quá trình huấn luyện, AI lấy hàng tỷ bức ảnh thực tế và liên tục thêm các lớp nhiễu hạt (noise) — giống như hình ảnh tĩnh nhiễu trên màn hình tivi hỏng — cho đến khi bức ảnh hoàn toàn biến thành một màn hình hỗn độn đầy các hạt trắng đen ngẫu nhiên.
- Giai đoạn khử nhiễu (Reverse Process): Nhiệm vụ cốt lõi của AI là học cách đảo ngược quá trình đó. Bắt đầu từ một khung hình hoàn toàn hỗn độn chứa đầy nhiễu, mạng thần kinh nhân loại sẽ từng bước bóc tách, dọn dẹp các lớp nhiễu dựa trên ý nghĩa của câu lệnh văn bản để tái tạo lại cấu trúc, ánh sáng và chi tiết của chủ thể một cách sắc nét nhất.
Mạng đối kháng sinh (GANs) và cuộc đua giữa “Kẻ làm giả” và “Cảnh sát”
Trước khi mô hình khuếch tán thống trị, một kiến trúc mang tính cách mạng khác đã đặt nền móng cho hình ảnh giả lập siêu thực chính là Mạng đối kháng sinh (GANs – Generative Adversarial Networks).
Hệ thống này hoạt động dựa trên sự cạnh tranh gay gắt giữa hai mạng nơ-ron thần kinh hoạt động độc lập:
- Mạng tạo sinh (Generator): Đóng vai trò như một “kẻ làm giả”, có nhiệm vụ tạo ra những hình ảnh mới từ dữ liệu ngẫu nhiên nhằm đánh lừa hệ thống khác.
- Mạng phân biệt (Discriminator): Đóng vai trò như một “cảnh sát” tinh anh, liên tục so sánh hình ảnh do mạng tạo sinh làm ra với hàng triệu bức ảnh thật trong kho dữ liệu để tìm ra các lỗi ngụy tạo.
Qua hàng triệu vòng lặp tự huấn luyện không ngừng nghỉ, “kẻ làm giả” ngày càng trở nên tinh vi hơn trong việc bắt chước ánh sáng, bóng đổ, texture da người và luật phối cảnh, đến mức “cảnh sát” hoàn toàn không thể phân biệt được đâu là ảnh thật, đâu là ảnh do máy tính vẽ ra.
Từ hình ảnh tĩnh đến video chuyển động mượt mà: Thách thức không gian và thời gian
Nếu việc tạo ra một bức ảnh tĩnh đòi hỏi hiểu biết sâu sắc về không gian hai chiều, thì việc tạo ra video của AI lại là một thử thách cấp số nhân vì nó đòi hỏi sự tuân thủ tuyệt đối các định luật vật lý trong không gian ba chiều và thời gian bốn chiều.
Để tạo ra các đoạn video giống thật (như công nghệ Sora của OpenAI), AI không chỉ xử lý từng khung hình rời rạc mà sử dụng các mô hình không – thời gian (Spatio-temporal models). Công nghệ này giúp máy tính hiểu được:
- Tính liên tục của vật thể: Một chiếc ô tô di chuyển từ trái sang phải phải giữ nguyên hình dạng, màu sắc và kích thước tương đối qua từng khung hình mà không bị biến dạng bất thường.
- Hiệu ứng vật lý tự nhiên: Cách dòng nước chảy xiết va vào đá, ánh sáng khúc xạ qua làn khói, hay trọng lực tác động lên vật thể rơi đều được AI mô phỏng chính xác dựa trên việc học hàng ngàn giờ video thực tế.
Kho dữ liệu huấn luyện khổng lồ và khả năng nhận diện mẫu hình
Sức mạnh thực sự giúp AI tạo ra hình ảnh và video giống thật nằm ở kho dữ liệu khổng lồ (Dataset) mà nó được nạp vào trong quá trình huấn luyện. Hàng tỷ hình ảnh, video, tác phẩm nghệ thuật, mô hình 3D trên internet cùng các siêu dữ liệu mô tả chi tiết (alt text, chú thích) đã được đưa vào các siêu máy tính.
Thông qua quá trình học sâu (Deep Learning), AI không ghi nhớ từng bức ảnh đơn lẻ mà nó nắm bắt các mẫu hình toán học (Patterns). Nó hiểu rằng khuôn mặt con người có khoảng cách đôi mắt ra sao, ánh sáng phản chiếu trên bề mặt kim loại như thế nào, hay nếp nhăn trên vải vóc chuyển động ra sao theo từng góc nhìn. Khi kết hợp các mẫu hình này lại, AI có thể tự do “sáng tác” ra những khoảnh khắc chưa từng tồn tại trong thế giới thực nhưng lại hoàn toàn hợp lý về mặt thị giác.
Những mặt trái và thách thức đạo đức khi AI làm giả hiện thực
Khả năng tạo ra hình ảnh và video giống thật của AI mở ra cuộc cách mạng lớn trong ngành điện ảnh, thiết kế, quảng cáo và trò chơi điện tử, giúp giảm thiểu chi phí sản xuất khổng lồ. Tuy nhiên, nó cũng đồng thời gióng lên hồi chuông cảnh báo về các vấn đề xã hội:
- Nạn tin giả và Deepfake: Công nghệ này dễ dàng bị lợi dụng để tạo ra các video giả mạo phát ngôn của chính trị gia, người nổi tiếng hoặc tạo ra các hình ảnh nhạy cảm nhằm bôi nhọ danh dự cá nhân.
- Bản quyền sở hữu trí tuệ: Việc AI “học” từ hàng triệu tác phẩm của các họa sĩ, nhiếp ảnh gia con người mà không có sự cho phép hay trả phí đang tạo ra những cuộc tranh cãi pháp lý chưa có hồi kết.
Kết luận
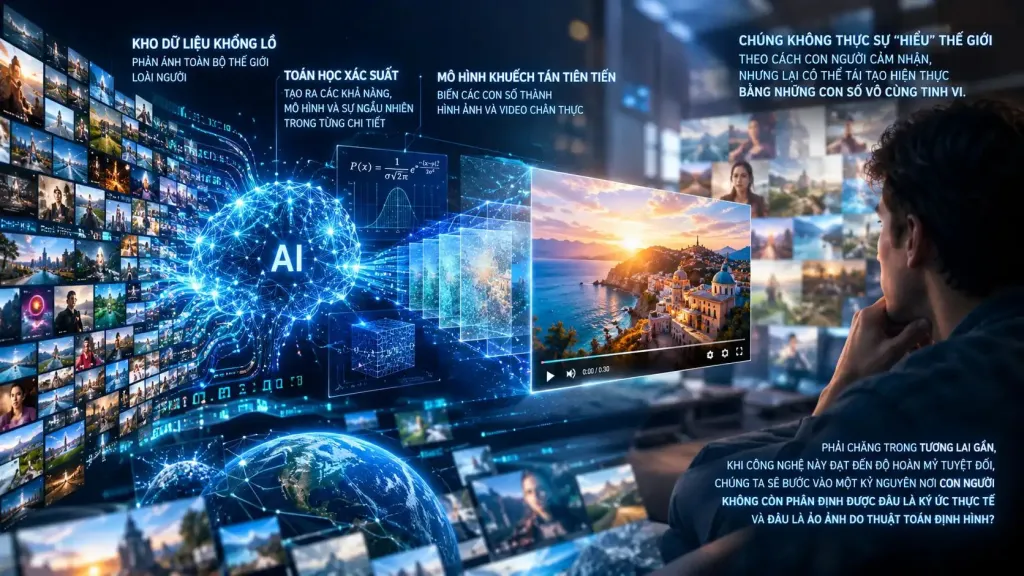
Trí tuệ nhân tạo có thể tạo ra hình ảnh và video trông giống thật nhờ sự kết hợp đỉnh cao giữa toán học xác suất, mô hình khuếch tán tiên tiến và kho dữ liệu khổng lồ phản ánh toàn bộ thế giới loài người. Chúng không thực sự “hiểu” thế giới theo cách con người cảm nhận, nhưng lại sở hữu năng lực tái tạo hiện thực bằng những con số vô cùng tinh vi. Phải chăng trong tương lai gần, khi công nghệ này đạt đến độ hoàn mỹ tuyệt đối, chúng ta sẽ bước vào một kỷ nguyên nơi con người không còn phân định được đâu là ký ức thực tế và đâu là ảo ảnh do thuật toán định hình?
Nguồn tham khảo:
OpenAI – Research on Diffusion Models, Spatio-Temporal Video Generation & Sora Architecture (https://openai.com/)
Midjourney – Generative AI, Image Synthesis & Neural Network Model Documentation (https://www.midjourney.com/)
Stability AI – Stable Diffusion & Generative Adversarial Networks (GANs) Mechanics (https://stability.ai/)
Bạn thấy bài viết này thế nào?
5,0/5 (1 lượt bình chọn)
2 lượt xem